打造开放兼容的AI软件新生态 人工智能应用软件开发的新范式
引言
人工智能(AI)正以前所未有的速度重塑各行各业,而AI应用软件作为技术落地的关键载体,其开发模式与生态构建方式直接决定了AI价值的释放程度。过去,AI软件开发往往依赖封闭的技术栈和孤立的平台,导致重复造轮、协同困难、创新受限。如今,打造开放兼容的AI软件新生态已成为产业共识,它为人工智能应用软件开发带来了全新的范式。
一、为什么需要开放兼容的AI软件新生态?
- 技术碎片化倒逼开放:深度学习框架、模型格式、硬件加速器百花齐放,若每个项目都从头适配,成本极高。开放兼容的生态能让不同组件像积木一样组合。
- 降低开发门槛:中小企业和个人开发者难以承担全栈自研。开放生态提供预训练模型、工具链和云服务,让AI应用开发从“手工作坊”走向“工业化”。
- 避免厂商锁定:封闭生态易导致用户被单一供应商绑架。开放标准(如ONNX、MLIR)和开源项目确保了跨平台的可移植性。
- 加速创新迭代:社区共享代码、数据集和最佳实践,使新算法、新应用能迅速传播和优化。
二、开放兼容ai软件新生态的核心要素
一个健康的AI软件生态应具备以下特征:
- 开放标准与接口:如ONNX(开放神经网络交换格式)、OpenVINO、PMML等,实现模型跨框架、跨硬件部署。
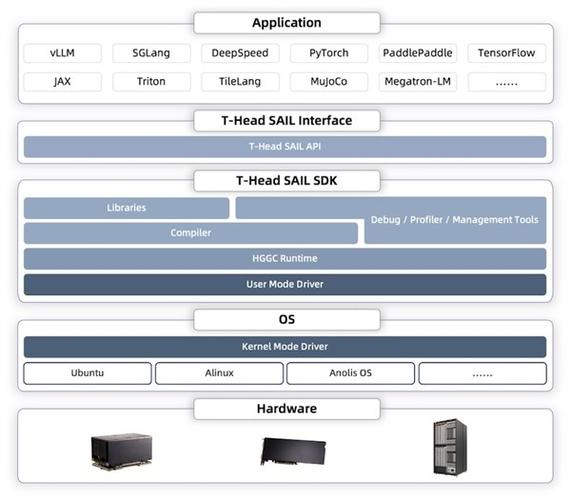
- 开源框架与工具链:TensorFlow、PyTorch、MindSpore、PaddlePaddle等相互借鉴,并通过适配层互通。
- 模块化与可组合性:数据预处理、特征工程、模型训练、推理、监控等环节均可替换。
- 跨平台运行能力:支持云、边、端多种部署环境,屏蔽底层硬件差异。
- 社区治理与协作:基金会(如LF AI & Data)、开源社区共同维护核心项目。
- 互操作性与兼容性:能与现有IT系统(数据库、消息队列、微服务)无缝集成。
三、人工智能应用软件开发的关键实践
在开放兼容生态下,AI应用软件开发需遵循以下实践:
- 以模型为中心转向以数据与流程为中心:利用开放格式管理模型,并将AI开发融入CI/CD/CT(持续集成/持续交付/持续训练)流水线。
- 采用MLOps:通过开源工具(MLflow、Kubeflow、Airflow)实现实验跟踪、模型注册、自动化部署与监控。
- 优先使用开放模型与数据集:如Hugging Face上的预训练模型,减少重复训练,加速产品化。
- 设计可移植的推理引擎:采用ONNX Runtime、TVM、OpenVINO等,确保模型在不同硬件上高效运行。
- 注重隐私与安全:借助联邦学习、差分隐私等开源框架,在开放的同时保护数据。
- 构建领域特定语言(DSL)与低代码平台:让业务人员也能参与AI应用构建,扩大生态参与者。
四、挑战与应对
- 兼容性成本:不同框架版本、算子语义差异可能导致移植失败。应对:加强标准测试套件(如ONNX Backend Test)。
- 性能损耗:跨框架转换可能损失性能。应对:使用图优化、算子融合及硬件专用加速库。
- 社区治理难题:开源项目可能分裂或停滞。应对:引入中立基金会,建立贡献者协议和路线图。
- 商业与开源的平衡:企业担心开源核心削弱竞争力。应对:采用开放核心(Open Core)模式,基础开源、高级功能商业授权。
五、未来展望
随着大模型和生成式AI的爆发,AI软件生态将更加依赖开放兼容。未来的AI应用开发可能呈现以下趋势:
- 模型即服务(MaaS)与开放模型市场:开发者可像选云服务一样调用各类模型。
- AI编译与统一中间表示:MLIR等将打通从训练到部署的全链路。
- 边缘AI与云边协同:开放生态使得模型能自动分割、协同推理。
- 联邦生态与数据空间:在保护隐私前提下实现跨机构模型共享。
##
打造开放兼容的AI软件新生态,不是简单的技术选型,而是一种战略选择。它要求开发者、企业和社区共同推动标准、共享成果、协同创新。只有这样,人工智能应用软件开发才能摆脱重复劳动,迈向高效、灵活、可持续的未来。让我们拥抱开放,兼容并蓄,共筑AI软件的新生态。